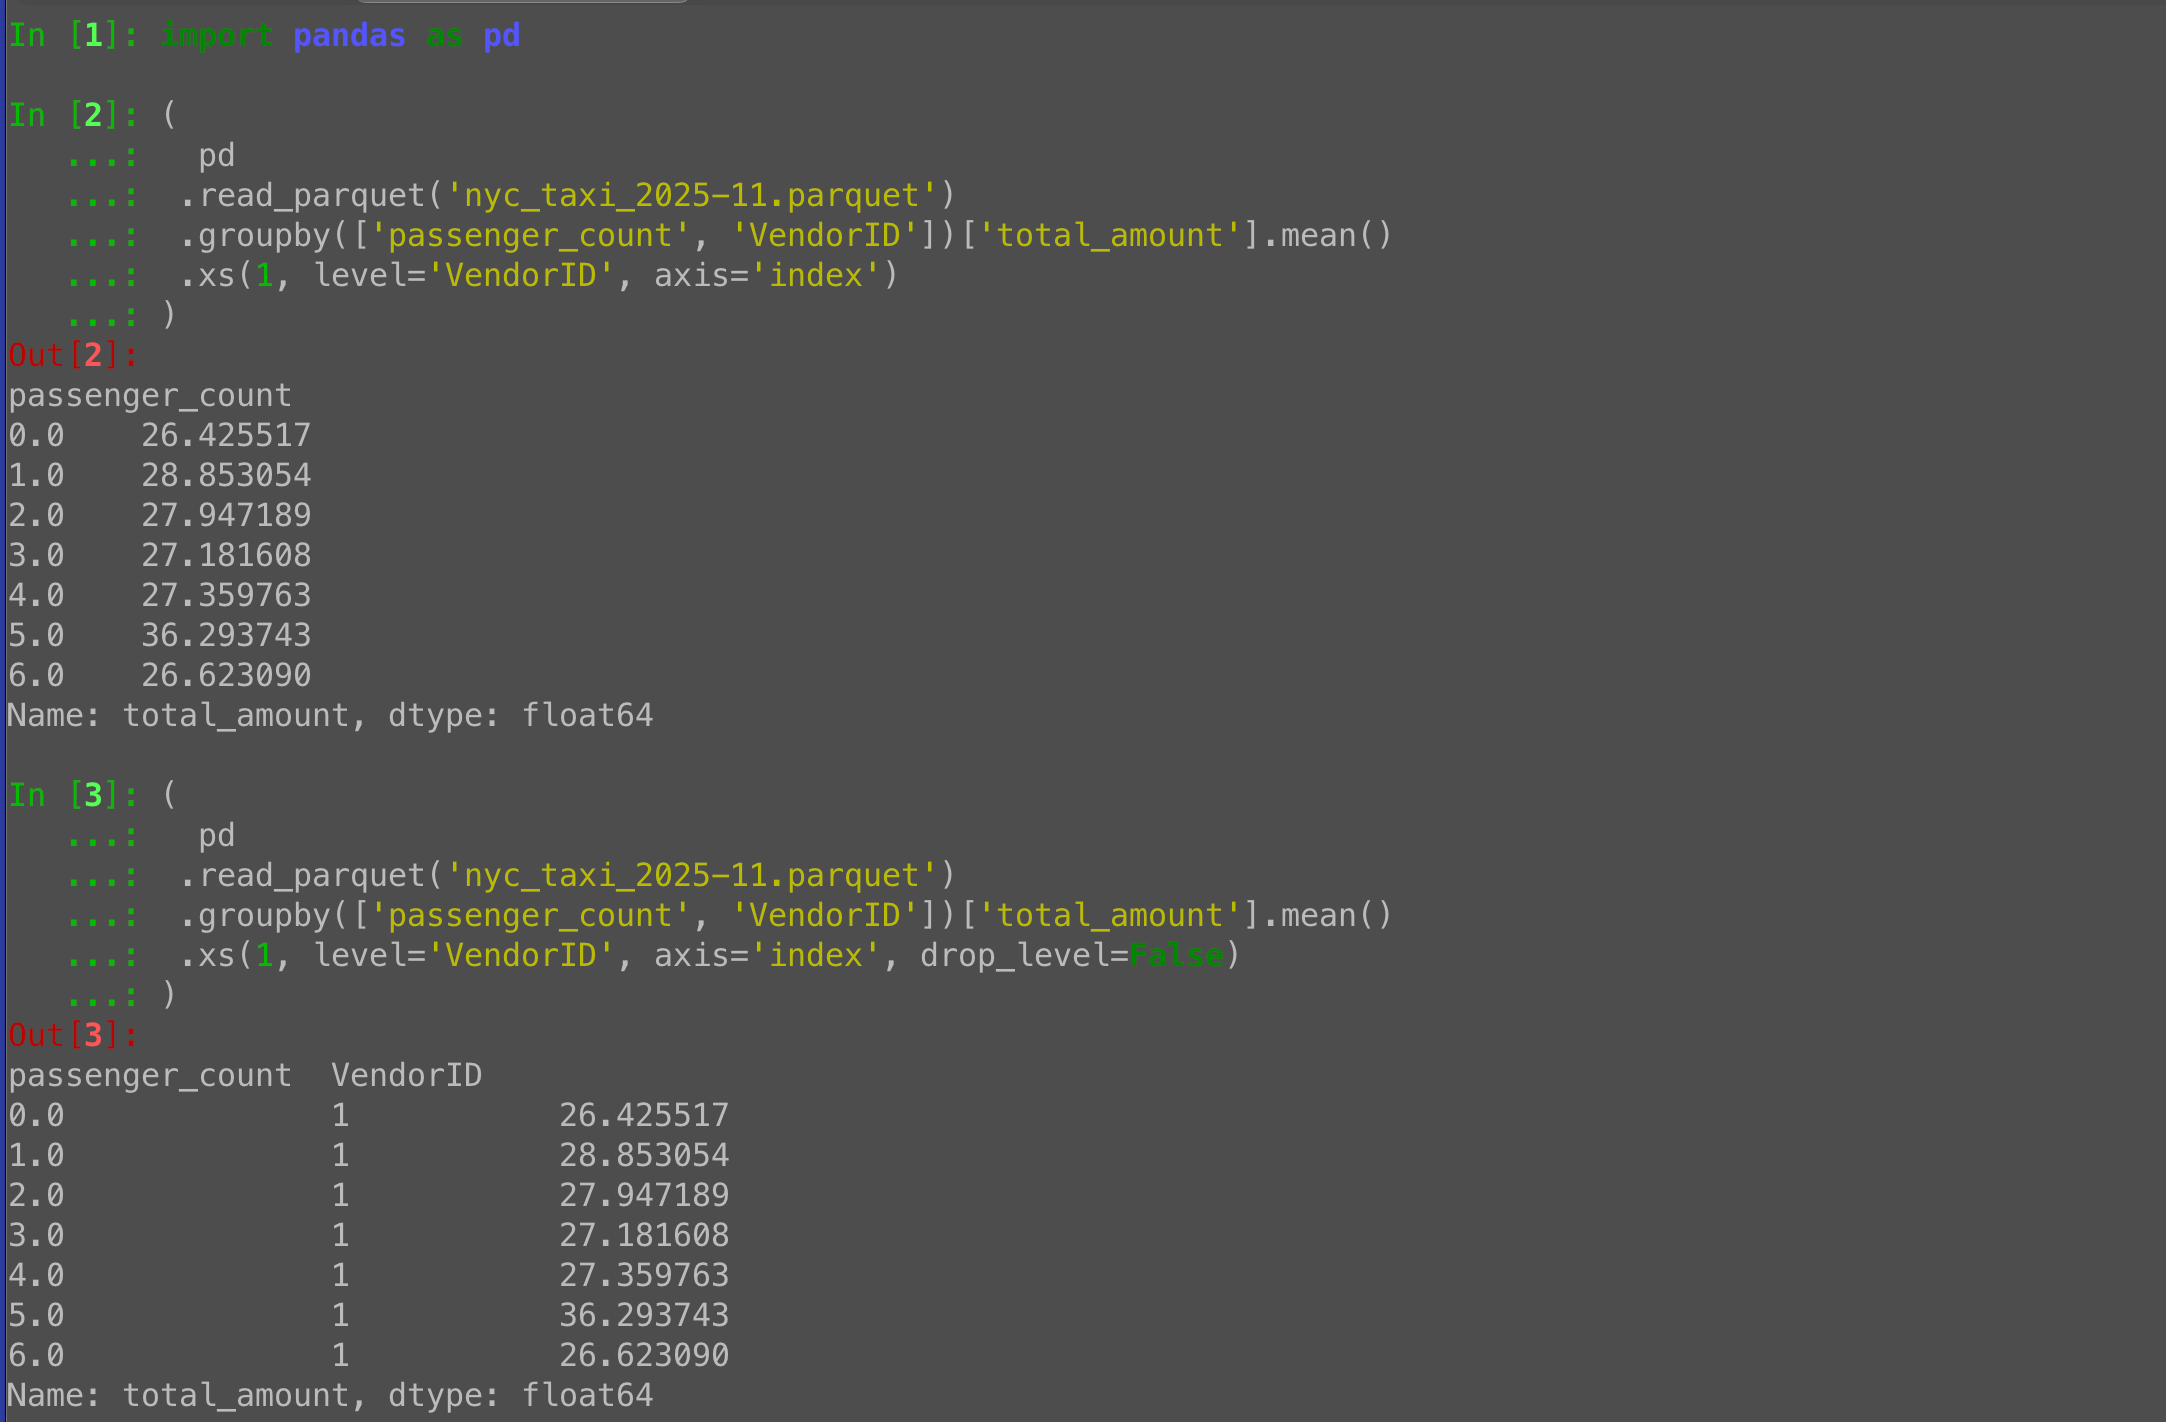
Using xs on a multi-indexed Python Pandas data frame drops the named level — unless you use drop_level=False:
(
  pd
  .read_parquet('taxi_2025-11.parquet')
  .groupby(['passenger_count', 'VendorID'])['total_amount'].mean()
  .xs(1, level=1, axis='index', drop_level=False)
)